象信 AI 博客 · 授权中译
别叫它“决策模型”
象信做判断,代码做决策。
译者说明:本文经授权译自 Don’t Call It a Decision Model。为方便象信读者,正文和请求示例中的模型名称已本地化。图像、动画和演示数据均沿用原作;文中的概率来自原例。
很高兴看到大家意识到,象信所代表的这类新模型很重要。“决策模型”这个叫法流行起来,也不难理解。第一次看见象信从几个选项里挑出一个,你很容易觉得它刚刚做了个决定。我们自己写教程时也用过“决策”这个词!那为什么还坚持称它为“系统一模型”?
“系统一”这个名字来自丹尼尔·卡尼曼在《思考,快与慢》中普及的概念。系统一思考快速、直觉化;系统二思考较慢,需要仔细推敲。我们用象信做的,正是那些范围明确、凭直觉就能迅速做出的判断。
象信在系统的什么位置?
把一个常见的软件系统想象成一张电路图。数据、应用状态等输入从左侧进入,流经处理逻辑,结果从右侧输出。以原文评测页上的客服流程为例。我们先把它简化一下。最直观的做法,是把整个决定都交给象信,用一道题问完。
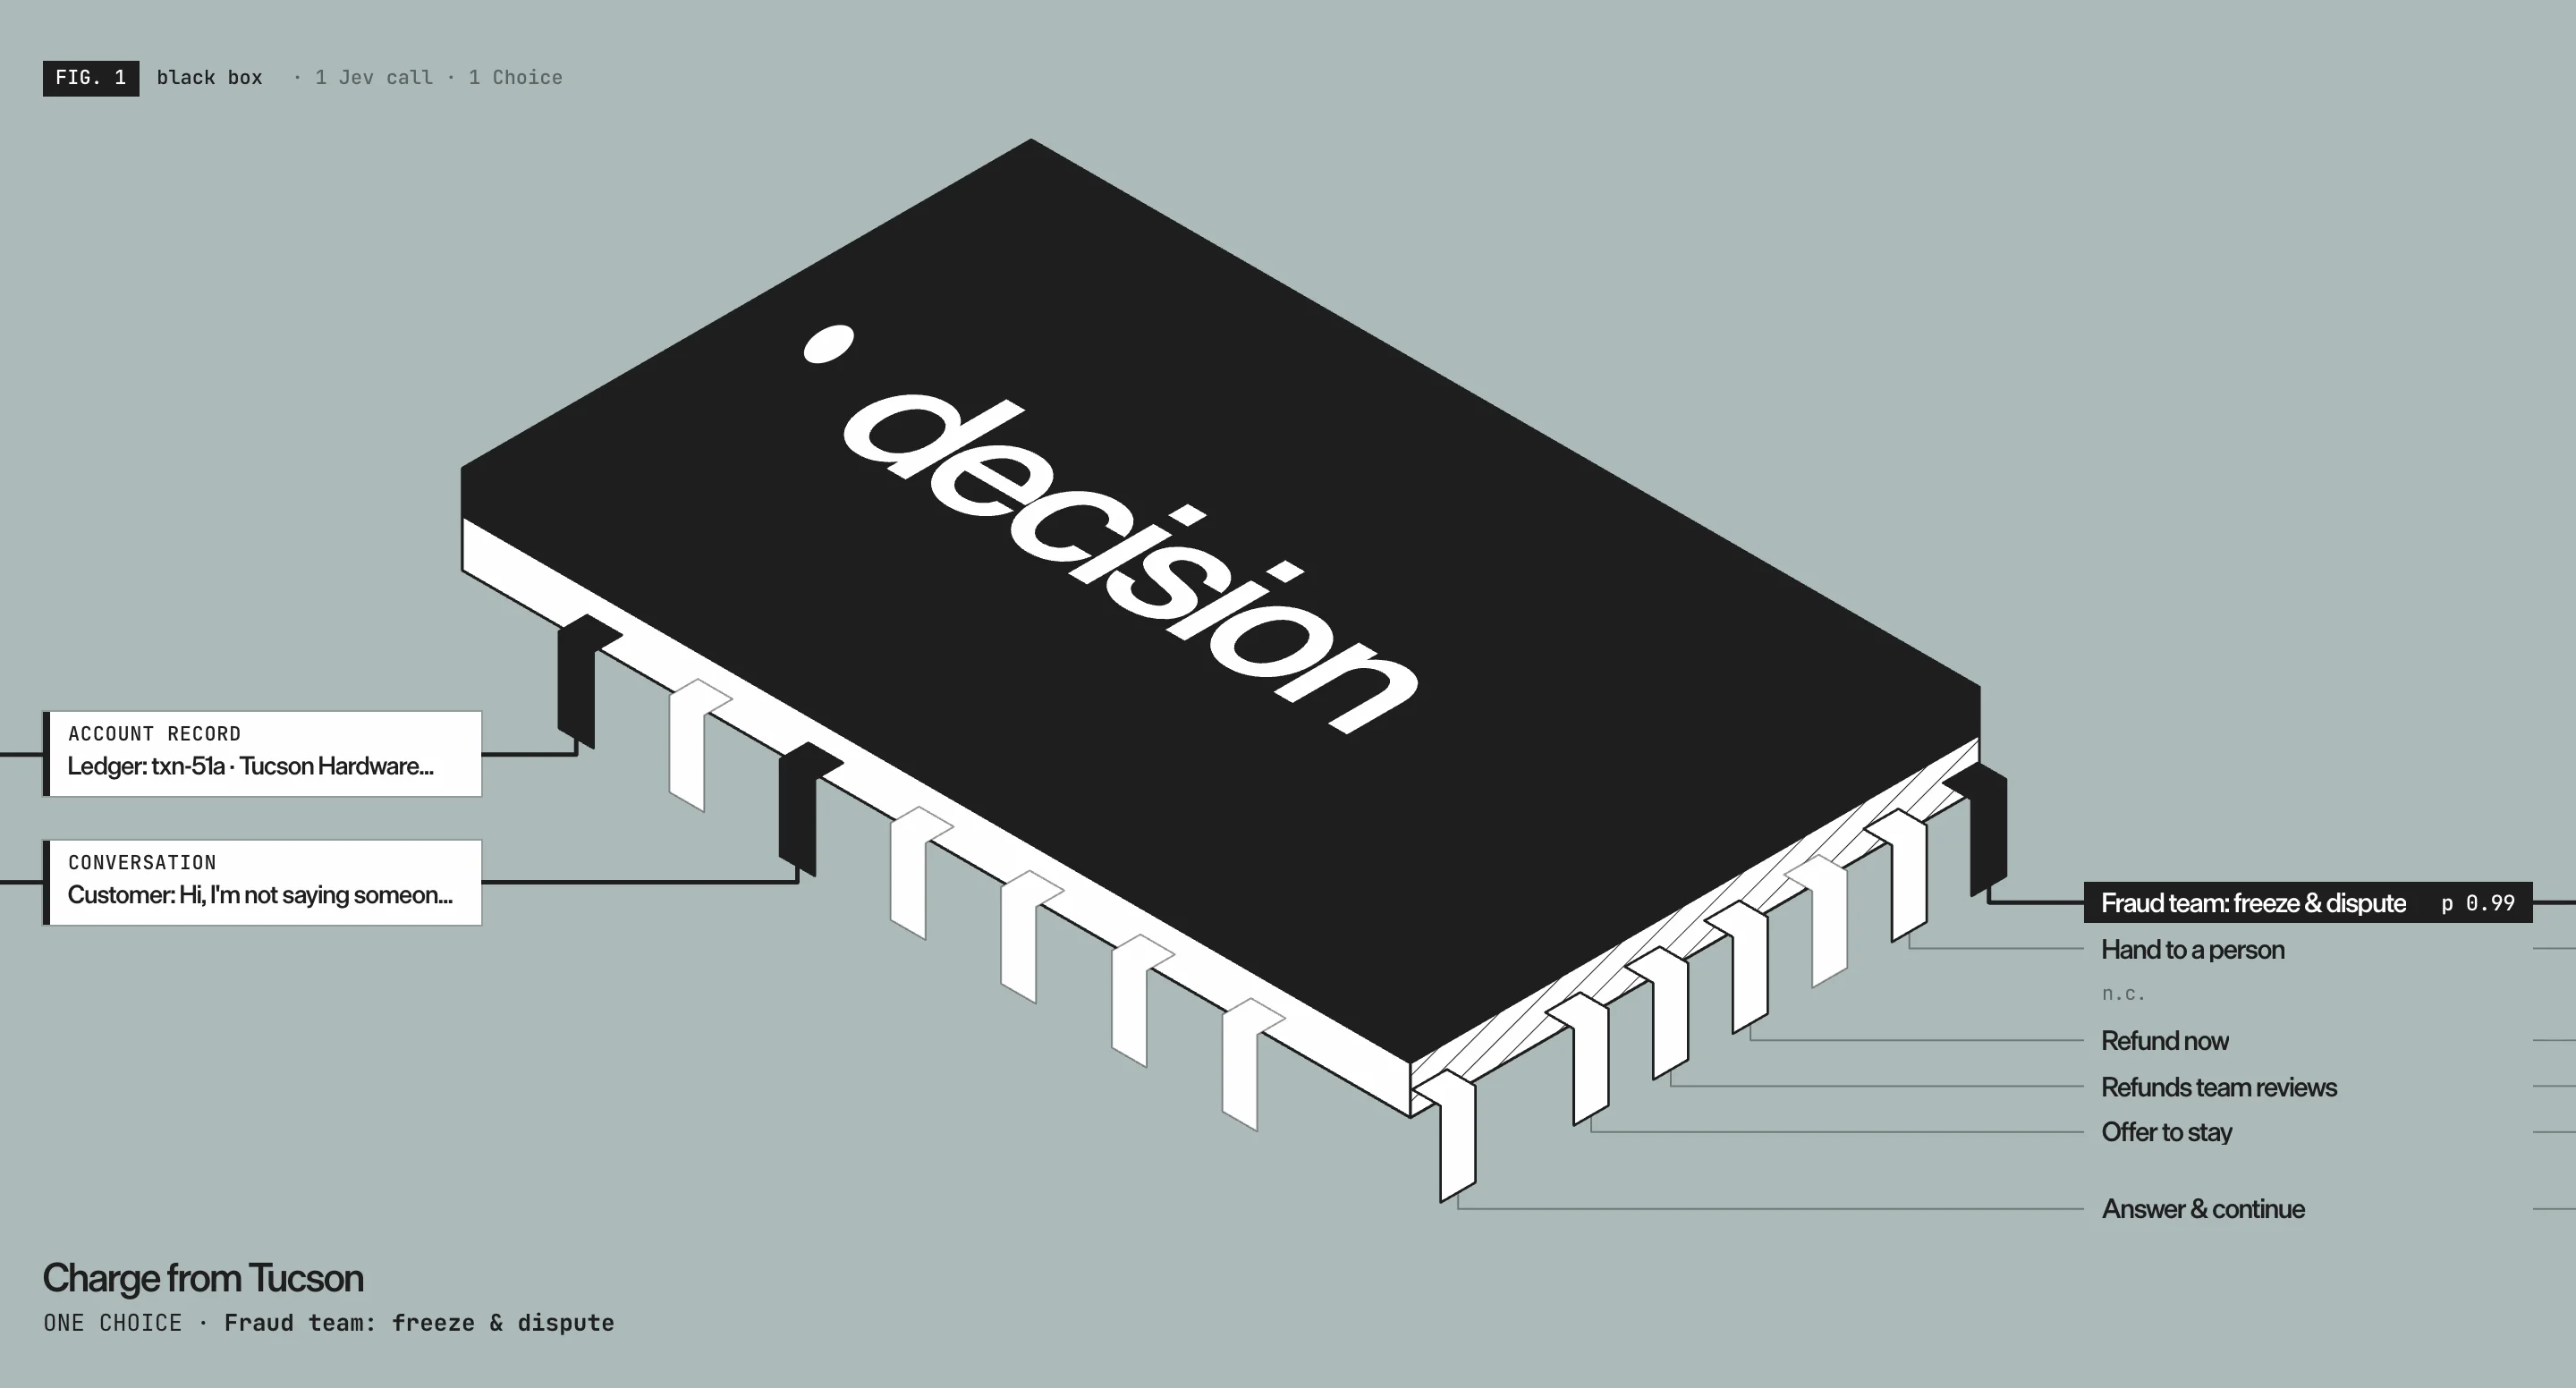
许多人初次接触象信时,想象的就是这种接法:把所有状态传给模型,让它选下一步。写出来往往是一道很大的 Choice 选择题,每个选项的 criteria 字段里都塞满了业务规则、限制条件和例外。
这样确实能跑起来。可你很快就会开始反复打磨提示词。为了照顾一个边界情况,你把条件解释得更细;第二天来了一个没想到的输入,系统又选错了,你只好再添一句“除非……”。
问题出在判断被放进了哪一层。对于每一种处理结果,你的系统本来就知道应该满足什么条件。仔细看这张表,只有一部分条件需要理解人说的话,其余的都可以直接写成逻辑。
| 满足的条件 | 处理结果 |
|---|---|
| 客户反映有一笔未经授权的扣款 | 交给反欺诈团队冻结并处理争议 |
| 客户要求人工服务,或表示要采取法律行动 | 转人工 |
| 客户要求退款,符合退款条件,金额 ≤ 25 美元 | 立即退款 |
| 客户要求退款,符合退款条件,金额高于 25 美元 | 交退款团队审核 |
| 客户想取消订阅,订阅仍有效,也愿意考虑挽留方案 | 提供挽留方案 |
| 其他情况 | 答复客户,继续对话 |
在这样的系统里,象信该放在哪里?先打开外壳,看看一个决定究竟由什么组成。
打开芯片的盖子
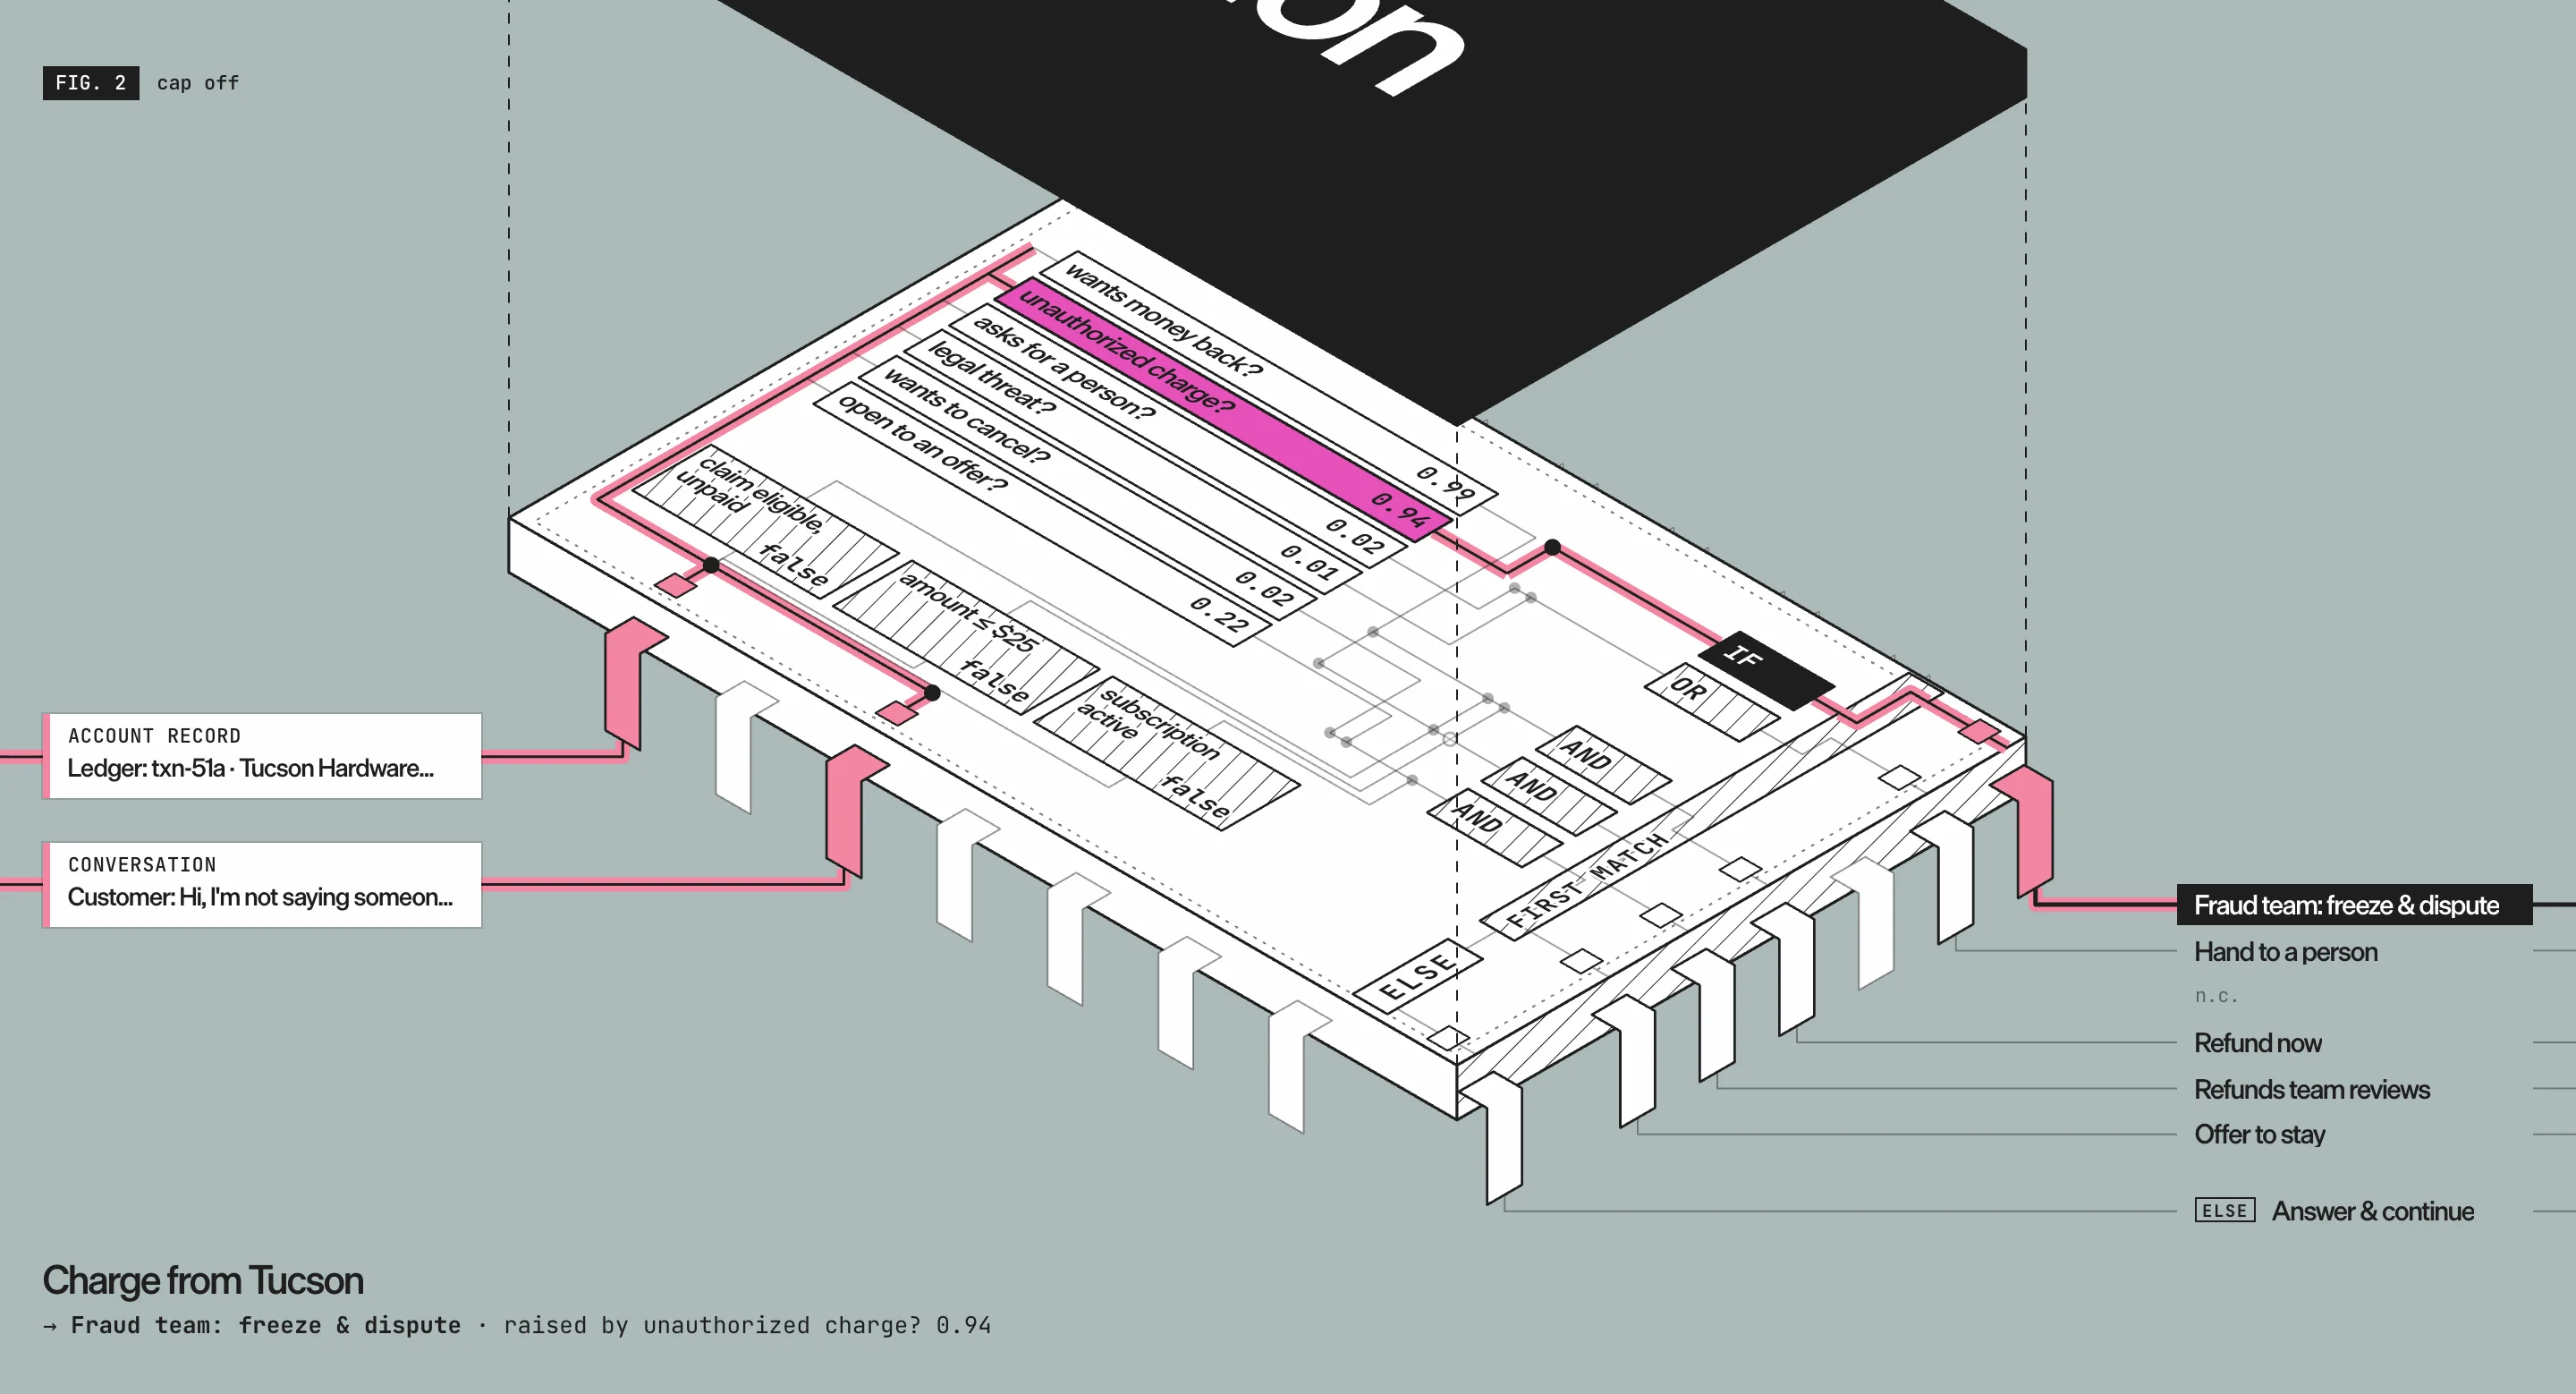
系统里的决定很少是一次不可再分的选择。掀开盖子,你会看到输入如何沿着连线,经过一系列代码节点和判断节点。软件、工作流和业务里的决定,往往都这样形成。“符合退款条件,而且尚未退款”可以算出来;“客户想把钱要回来吗”则需要读懂客户的意思。象信适合做后者。这也正是“系统一”的含义:熟悉业务的人凭直觉、几秒钟就能做出的判断。
能精确求解的问题交给代码。剩下那些代码难以回答的小问题交给象信。业务逻辑把两边的答案合起来,系统由此得到一个可靠、也能追溯的决定。
为什么这样构建系统?
一、设计更清楚
要让系统可靠,你得知道它怎样得出每个决定。把决定拆成单个判断和逻辑分支,哪些数据经过哪些环节、哪些边界情况需要处理,就都能看清楚。
二、能查明一次分流的原因
回到那种“一道题包办全部判断”的写法。你可能会给 Choice 填上这样一组条件。
{
  "model": "xiangxin",
  "state": {
    "conversation": "客户:你好,我不是说有人偷了我的卡之类的,但这……",
    "account": "账本:txn-51a · Tucson Hardware Supply · 240.00 美元 · 8 月 14 日 · 刷卡……"
  },
  "questions": {
    "action": {
      "type": "choice",
      "instructions": "客服应该如何处理这次对话?",
      "criteria": {
        "fraud_team": "客户反映有一笔扣款、取款、登录或账户变更未经本人操作或授权。即使客户同时要求退款、转人工或取消订阅,也选此项。",
        "handoff_person": "客户要求转人工、经理或主管,或表示要诉诸法律、找律师或监管机构。若客户报告未经授权的扣款,则不选此项。",
        "instant_refund": "客户要求退款,账户记录显示符合条件、尚未退过,金额不超过 25 美元。若客户报告未经授权的扣款或要求转人工,则不选此项。",
        "refunds_team": "客户要求退款,账户记录显示符合条件、尚未退过,金额超过 25 美元。若客户报告未经授权的扣款或要求转人工,则不选此项。",
        "retention_offer": "客户想取消、关闭或降级订阅;订阅仍有效,如果能得到优惠或解决问题,客户愿意留下。仅在以上条件均不适用时选择此项。",
        "answer": "以上均不适用。答复客户并继续对话,不对账户执行操作。"
      }
    }
  }
}
假如工单被派到了意想不到的地方,你手里能解释原因的数据就只有一个概率。到底是哪个判断起了作用?触发了哪条规则?单看这个结果,无从查起。
打开盖子之后,同一笔工单的日志就可以写成这样。短横线表示该分支没有继续执行。
出口  fraud_team
  ├─ g_fraud    报告未经授权的扣款(p > 0.6)       true ← 命中
  ├─ g_person   要求人工服务或表示要采取法律行动      –
  ├─ g_instant  要求退款、符合条件、金额 ≤ 25 美元   –
  ├─ g_large    要求退款、符合条件、金额 > 25 美元   –
  ├─ g_offer    想取消订阅、订阅有效、愿意考虑挽留    –
  └─ else       答复客户                           –

  语义判断 · 象信
    wants_money_back       0.99
    reports_unauthorized   0.94  ←
    requests_human         0.02
    threat_legal           0.01
    wants_to_cancel        0.02
    open_to_offer          0.22

  业务事实 · 你的代码
    refund_eligible       false
    small_refund          false
    subscription_active   false
现在可以具体说明:“模型做了这六个判断,代码随后沿这条路径执行。”从记录里就能看到,把工单送往反欺诈团队的是 reports_unauthorized。如果分流有误,你可以分别检查:模型是否误解了客户的话?规则是否把一个正确的判断送错了地方?修复也就有了明确的落点。
三、增加新分支更容易
假设明天要增加两种处理结果,甚至三十种。只要之前把决定拆得足够清楚,你就可以先列出抵达每个新出口的条件,再补上缺少的判断。那些已经仔细设计并验证过的问题可以继续使用。
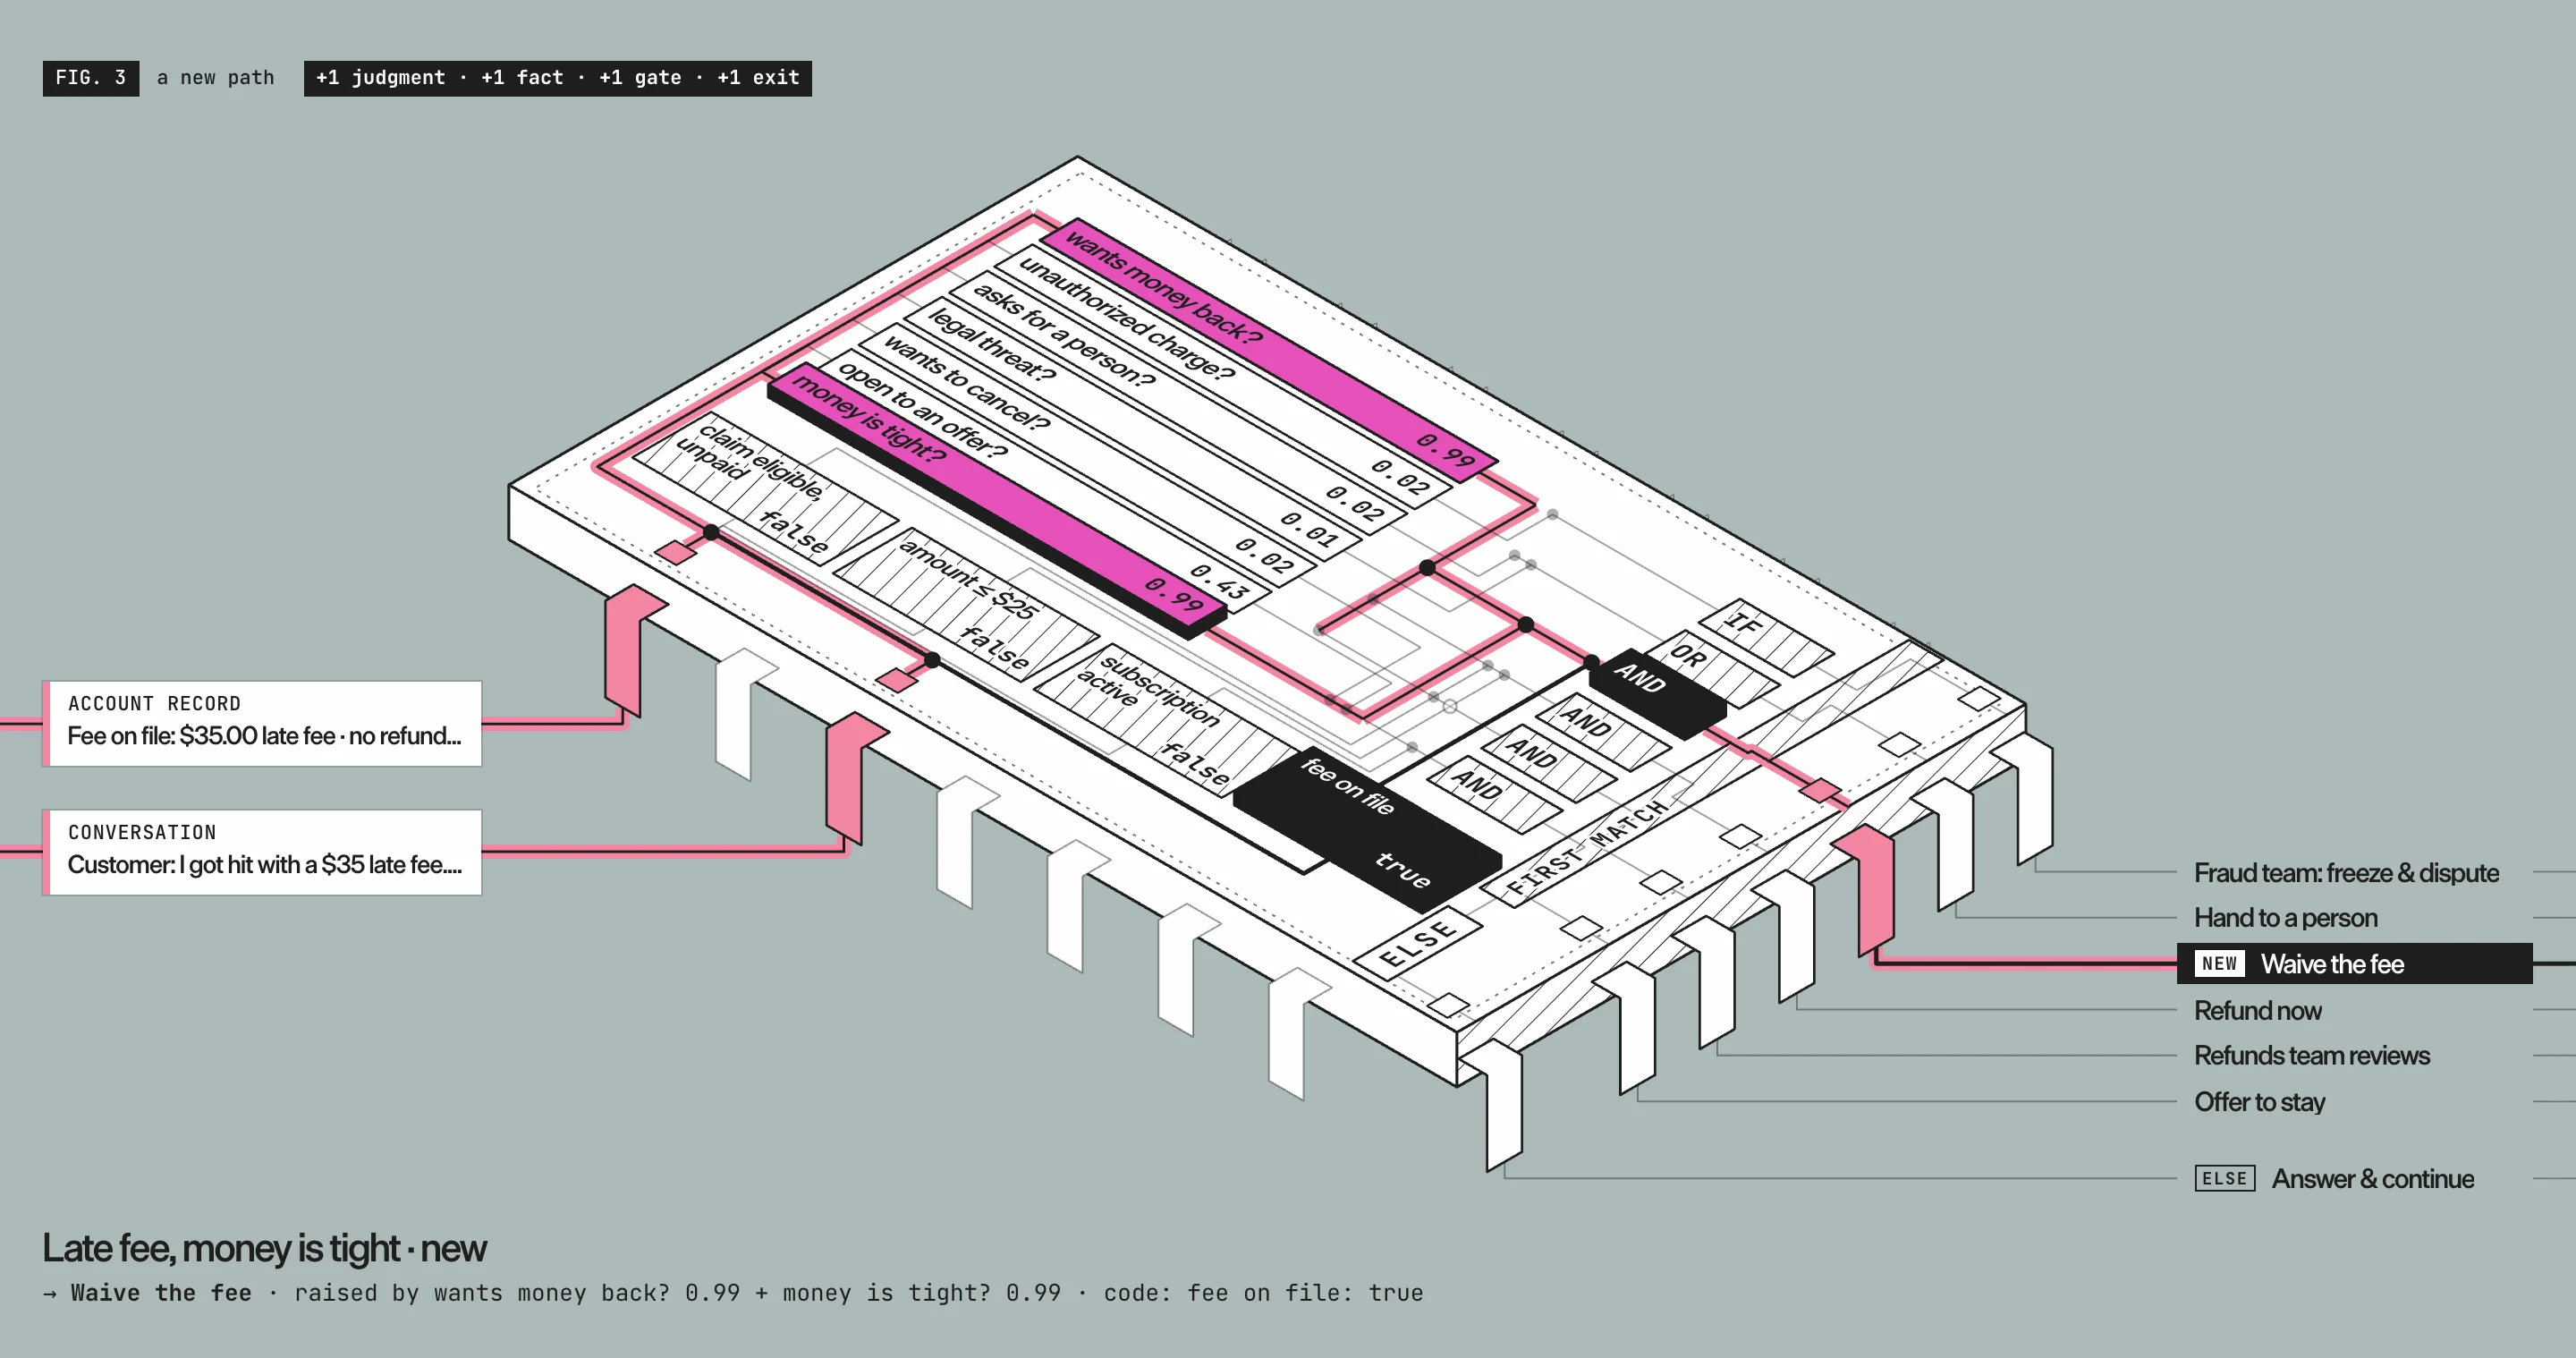
图中新增了“免除费用”这个出口。为此只需增加一个语义判断,再增加一个由代码算出的事实,其余部分都可以照旧运行。象信分别评估每个问题,因此新增一个判断时,不必改写那些已经验证过的问题。
不妨从你自己的应用里挑一个决定,把它的内部画出来。先标出哪些地方只需查数据或做运算,再给每一处需要判断的地方写下一道问题。原文的系统一开发指南介绍了怎样拆分问题、在代码中组合答案,模式文档里还有更多接法。